6.s081 Lab2 system calls 实现
Lab2 实现了两个系统调用层面的功能,在开始写代码之前要求先读完 xv6-book 的 Chapter 2 and Sections 4.3 and 4.4 of Chapter 4,以及相关的源文件,花了两天不到的时间。
做完这次实验可以深入理解 OS 的用户态、内核态的隔离,以及系统调用。
版本与验证入口
- 课程对照: MIT 6.S081 2021 · syscall,RISC-V xv6,课程实验分支
syscall。这里指定的是读者核对任务和接口的参考版本,文章发布日期是个人学习记录的日期。 - 本文范围: trace、sysinfo。系列的 Lab1—Lab9 是本博客的编号,以任务名称和课程分支定位源码。
- 历史证据: 本文未附当时个人作答仓库的 commit SHA 和完整评分日志,不能据此恢复完全相同的代码快照。已有实现说明与踩坑记录保留,下面的命令供重新验证时使用,不代表本次修订重新运行了 xv6 实验。
在自己的 syscall 作答工作目录中,先保存版本和工作区状态,再运行该版本提供的评分器:
git rev-parse HEAD
git status --short
git diff --stat
qemu-system-riscv64 --version
make grade
make grade 需要已配置该课程的 RISC-V 工具链和 QEMU;课程页列出了对应测试。保存完整输出、实际编译器版本和未提交修改,才能把之后的通过或失败关联到具体实现。只有 SHA 不能描述带有本地修改的工作区。
xv6-book Chapter 2 部分内容
操作系统的三个基本需求:复用、隔离、交互。
一、抽象物理资源
程序直接使用如CPU、内存、磁盘这样的硬件资源会较为复杂,很容易造成难以解决的问题,因此操作系统把CPU的使用抽象为进程,内存、磁盘、IO设备的使用抽象为open,read,write,close系统调用。
exec系统调用:丢弃当前进程的旧代码和数据,加载一个新的程序。
- 不改变PID。
- 重置内存:当前进程的堆栈、堆、代码段全部被替换为新程序的镜像。
- 文件描述符继承:原本打开的文件描述符在exec后依然是打开的。
exec为用户将可执行程序镜像存储到文件系统中提供了便利,通过这个系统调用,可以直接使用文件路径来加载程序而不是直接与物理内存打交道。
二、系统调用的过程
这是一个从 用户态(User Space) 跨越到 内核态(Kernel Space) 最后返回用户程序继续执行的过程,流程非常严谨,主要分为以下5个关键阶段:
第一阶段:用户态准备(User Space)
-
C函数调用:在用户态执行会引发系统调用的指令,比如
trace(mask)或sysinfo(&info),编译器会去寻找它的定义。 -
存根(Stub)
usys.S:修改的usys.pl会生成usys.S汇编代码,这是真正的入口:
print "# generated by usys.pl - do not edit\n";

print "#include \"kernel/syscall.h\"\n";

sub entry {
    my $name = shift;
    print ".global $name\n";
    print "${name}:\n";
    print " li a7, SYS_${name}\n";
    print " ecall\n";
    print " ret\n";
}a7寄存器:存储系统调用号,内核只会看这个寄存器来知道你想要干什么。ecall指令:这是CPU的硬件指令,一旦执行,CPU权限就会从User Mode提升到Supervisor Mode。
第二阶段:跨越边界(Trap)
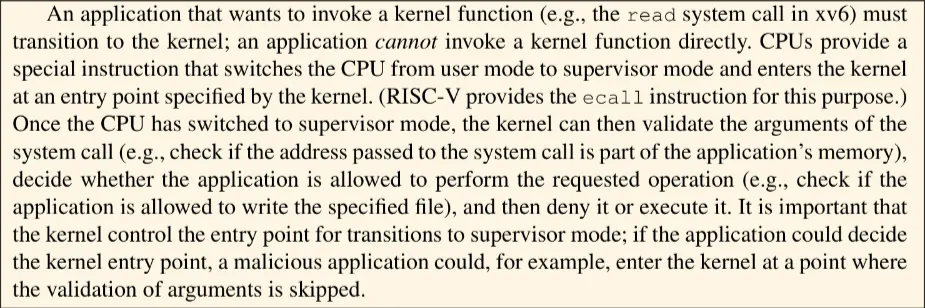
ecall执行的瞬间,硬件接管了控制权,发生了以下改变:
-
跳转:CPU读取
stvec寄存器(里面存着内核入口位置),跳转到trampoline.S中的uservec代码段。 -
权限提升:现在的代码在Supervisor Mode下运行。
第三阶段:蹦床机制(Trampoline)
此时内存页表(Page Table)还是用户进程的页表,内核代码大部分是看不见的。
-
保存现场(
uservec):在trampoline.S中,代码把所有用户寄存器中的内容(a0, a1, sp, pc等)都保存到p->trapframe中(这是内存中仅次于trampoline的地址最高的页,大小仅有一页),以便之后还可以返回用户程序继续运行。 -
切换页表:代码修改
satp寄存器,从用户页表切换到内核页表,此时内核才能真正访问内核内存空间。 -
跳转到C代码:最后跳转到
trap.c中的usertrap()函数。
第四阶段:分发与执行(Kernel Space)
现在安全地在内核C环境中了。
-
usertrap():它主要检查发生异常的原因(scause寄存器),根据寄存器中的8(系统调用的Exception Code)判断是系统调用引发异常。 -
syscall():从保存的上下文(trapframe->a7)中取出系统调用号。num = p->trapframe->a7; if(num > 0 && num < NELEM(syscalls) && syscalls[num]) { p->trapframe->a0 = syscalls[num](); } -
执行系统调用处理函数:这里设计我们实现的系统调用函数以及 xv6 原本已经实现好的系统调用函数,执行这些函数。
第五阶段:返回(Return)
任务完成,要返回用户程序继续执行。
-
设置返回值:刚刚
syscall()中已经将系统调用函数的返回值存进了p->trapframe->a0中,在RISC—V中a0寄存器用于存放返回值。 -
usertrapret():关中断,准备返回用户态,设置stvec指向trampoline以便下次系统调用能找回来。 -
userret:再次切换页表(内核页表->用户页表)。把trapframe中保存的寄存器值全部恢复到CPU中。 -
sret:这是ecall的逆操作,可以从Supervisor Mode返回User Mode,PC中的值恢复到刚刚产生异常时应该执行的下一行代码(这里会根据异常种类的不同而指向原本引发中断的代码或原本引发中段的下一行代码。与操作系统理论课中学过的内容一致)。
Lab2 实现
实现了两个简单的系统调用:
一、System call tracing (moderate)
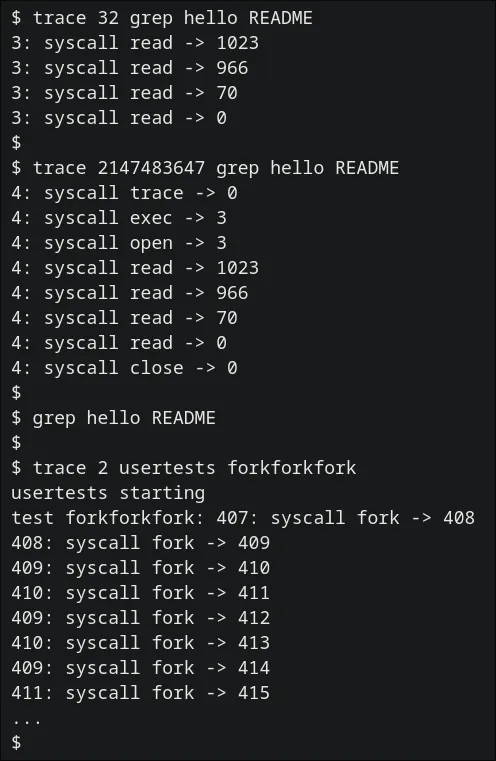
实现一个根据掩码(mask)对系统调用进行追踪的系统调用,使用trace指令后会发出一个系统调用,例如trace(1 << SYS_fork)就可以对fork这个系统调用进行追踪,返回所追踪的系统调用的 pid、系统调用名以及返回值(如下图),对后续的debug过程有一定帮助。
根据上面提到的系统调用的过程,如果想要为操作系统添加一个系统调用,需要进行以下步骤:
1.添加系统调用存根(Stub)
修改user/usys.pl
# ...
entry("trace");
# ...
2.添加函数签名
我们会在用户程序中使用系统调用函数,因此要修改user/user.h
// system calls
// ...
int trace(int);
// ...
3.添加系统调用
在kernel/syscall.h中添加一个系统调用号的宏定义:
系统调用号唯一,这里要不同于之前的系统调用号。
// ...
#define SYS_trace  22
// ...修改kernel/syscall.c中的一些静态变量:
- 申明全局系统调用函数:
// ...
extern uint64 sys_trace(void);
// ...- 添加
syscalls,目的是通过系统调用好能够找到对应的系统调用:
static uint64 (*syscalls[])(void) = {
// ...
[SYS_trace]   = sys_trace,
// ...
};
- 新增一个
syscall_names静态数组用于将系统调用号映射为相应系统调用名:
static char *syscall_names[] = {
  [SYS_fork]    = "fork",
  [SYS_exit]    = "exit",
  [SYS_wait]    = "wait",
  [SYS_pipe]    = "pipe",
  [SYS_read]    = "read",
  [SYS_kill]    = "kill",
  [SYS_exec]    = "exec",
  [SYS_fstat]   = "fstat",
  [SYS_chdir]   = "chdir",
  [SYS_dup]     = "dup",
  [SYS_getpid]  = "getpid",
  [SYS_sbrk]    = "sbrk",
  [SYS_sleep]   = "sleep",
  [SYS_uptime]  = "uptime",
  [SYS_open]    = "open",
  [SYS_write]   = "write",
  [SYS_mknod]   = "mknod",
  [SYS_unlink]  = "unlink",
  [SYS_link]    = "link",
  [SYS_mkdir]   = "mkdir",
  [SYS_close]   = "close",
  [SYS_trace]   = "trace",
  [SYS_sysinfo] = "sysinfo",
};
4.实现 trace 系统调用
首先添加实现trace必要的额外变量:
struct proc {
  // ...
  int trace_mask;
};这个变量用于在进程中存储trace的掩码。
系统调用的实现都在kernel/sysproc.c中,因此在这个文件中添加一个函数sys_trace,与上面的syscalls中添加的函数名一致。
uint64
sys_trace(void)
{
  int mask;

  if(argint(0, &mask) < 0)
    return -1;
  myproc()->trace_mask = mask;

  return 0;
}其中argint函数用于获取引发系统调用的函数中的参数,这里为trace所需要的掩码,获取到后将其存放到当前进程的proc状态结构体中。
此时系统调用需要做的事情已经准备好,但是想要能够监测系统调用,还需要在syscall()函数中添加几行代码将检测到的内容输出:
void
syscall(void)
{
  int num;
  struct proc *p = myproc();

  num = p->trapframe->a7;
  if(num > 0 && num < NELEM(syscalls) && syscalls[num]) {
    p->trapframe->a0 = syscalls[num]();

    if (p->trace_mask & (1 << num)) {
      printf("%d: syscall %s -> %d\n",
             p->pid,
             syscall_names[num],
             p->trapframe->a0);
    }
  } else {
    printf("%d %s: unknown sys call %d\n",
            p->pid, p->name, num);
    p->trapframe->a0 = -1;
  }
}
二、Sysinfo (moderate)
这个系统调用的功能更是收集这个正在运行的系统的信息sysinfo接收一个指向struct sysinfo的指针作为参数,内核应该填充这个结构体的各个字段:
freemem:内存空闲的字节数nproc:state不为UNUSED的进程数(也就是正在运行的进程数)
基本系统调用需要添加的内容与上一个任务一样,除此之外这个实现中涉及内核态向用户态传递内核的一些数据,这就是这个任务的唯一难题了,此处可以参考xv6-book Sections 4.3 and 4.4 of Chapter 4。
先观察一下struct sysinfo:
struct sysinfo {
  uint64 freemem;   // amount of free memory (bytes)
  uint64 nproc;     // number of process
};
主要就是两个 uint64 字段,因此只要获取到这两个字段的内容就好了。
指导书中给出提示参考sys_fstat()函数以及filestat()函数,告诉我们如何从内核中向用户空间中写入数据。
这两段代码演示了两个重要的函数:argaddr以及copyout。
- argaddr:与argint/argfd类似,获取第n个系统调用函数作为(地址/整数/文件描述符)。
The kernel functions argint, argaddr, and argfd retrieve the n’th system call argument from the trap frame as an integer, pointer, or a file descriptor.
- copyout:从内核空间中拷贝数据到用户提供的地址(这里的地址是用户页表下的虚拟地址,因此可以防止攻击其他的用户进程)。
copyinstr (kernel/vm.c:403) copies up to max bytes to dst(destination) from virtual address srcva in the user page table pagetable. … A similar function, copyout, copies data from the kernel to a user-supplied address.
了解了上面的内容后sys_sysinfo的实现只需要获取到空闲内存以及进程数了,还需要自己添加两个函数来获取freemem和nproc:kget_freemem以及get_nproc。
uint64
kget_freemem(void)
{
  struct run *r;
  int num = 0;

  acquire(&kmem.lock);
  r = kmem.freelist;
  while (r) {
    num++;
    r = r->next;
  }
  release(&kmem.lock);

  return num * PGSIZE;
}
kget_freemem函数访问kmem结构体,其中有两个内容:一个结构体的锁和空闲物理内存链表的表头指针。
struct {
  struct spinlock lock;
  struct run *freelist;
} kmem;
这里的自旋锁不做过多解释,后面会有lab详细涉及,这里只需要获取和释放就行了。
freelist是利用了页表的前8个字节作为指针指向下一个页表的起始地址,因此只需要不断遍历链表就可以获取空闲页表的数量,在这个基础上乘以页表大小就可以获取到freemem。
接下来实现collect_nproc函数,只需要遍历一下kernel/proc.c中的proc数组,统计有多少个p->state不为UNUSED即可:
uint64
get_nproc(void)
{
  struct proc *p;
  uint64 n = 0;

  for (p = proc; p < &proc[NPROC]; p++) {
    if (p->state != UNUSED)
      n++;
  }

  return n;
}
最后实现一下sys_sysinfo系统调用函数,使用argaddr和copyout将以上函数获取到的信息写入用户空间中:
uint64
sys_sysinfo(void)
{
  uint64 addr;
  struct proc *p = myproc();
  struct sysinfo info;

  if (argaddr(0, &addr) < 0) {
    return -1;
  }

  info.freemem = kget_freemem();
  info.nproc = get_nproc();

  if (copyout(p->pagetable, addr, (char *)&info, sizeof(info)) < 0)
    return -1;
  return 0;
}
以上就是 Lab2 的所有内容,完成这个需要也会加深对操作系统的系统调用相关知识的理解。目前还不了解为什么我修改的是syscall()中的源码,按照我的理解是我修改完后无论使用什么系统调用都会输出trace信息,但实际上只有使用了trace命令后才会输出相应内容。(STUPID!!没使用trace命令mask为0,不会有任何系统调用能匹配)。