只有编辑器和构建工具,如何从零构建一个完整系统?
1. 我把“完整系统”讲复杂了
这篇文章的上一版里有 System Contract、状态机、Owner、Failure Matrix、Metrics 和一长串 Gate。它们分别都能在软件工程书里找到正确的位置,但放在“如何从零开始”这个问题前面,就变成了一组来历不明的规矩。
读完以后,我仍然不知道明天打开编辑器应该写哪一行。
真正的问题其实很朴素:假设没有 IDE 替我创建目录,没有脚手架替我选择架构,手边只有一个能编辑文本的工具和一个能重复执行命令的构建工具,我怎样从空目录出发,最后留下一个别人能读、能运行、能修改的项目?
答案也应该从空目录开始,而不是从“一个完整系统应该有多少模块”开始。
一个完整系统,不过是一组能互相解释的普通文件。
这里的“只有编辑器和构建工具”不是说计算机上没有操作系统、编译器或 Python Runtime;它的意思是:不依赖 IDE 中不可见的按钮和状态。编辑器负责改变文件,构建工具负责把“如何得到结果”变成可重复的命令。换成 C++,它可以是 CMake;在本文的 Python Lab 里,它是 uv 和 pyproject.toml。
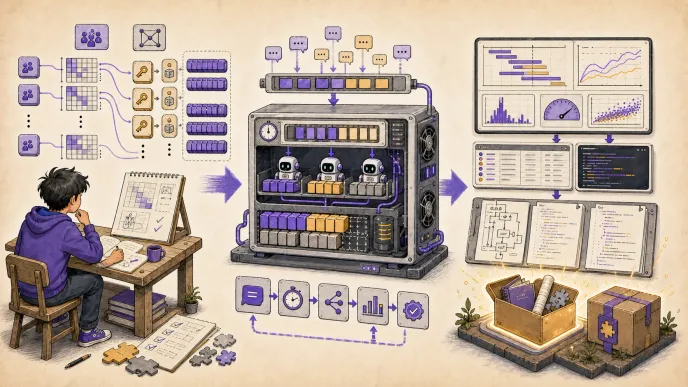
2. “完整”不是文件多
先看两个极端。
一个 main.py 可以完成真正的工作;十层目录也可以什么都做不了。Docker、CI、数据库和 Dashboard 会让项目看起来很像系统,却不能代替一个正确的输入输出。
所以,本文把“完整”定义成四件能现场演示的事:
- 从干净环境可以构建并运行;
- 一条真实输入可以走到可观察的输出;
- 错误实现会被测试或检查明确拒绝;
- 下一位开发者知道从哪里修改,并能判断自己有没有改坏。
这不是“大规模生产平台”的定义。单机上的教学项目也可以完整;部署在十台机器上的服务也可能只有 Happy Path。完整不是规模,而是项目在自己声明的范围里没有依赖作者口头施法。
3. 空目录里的第一件东西:一个能失败的例子
以我现在的 p2-inference-systems Lab 为例。最初要回答的问题并不是“如何设计一个 AI Infra 平台”,而是:
对同一组输入和权重,使用 KV Cache 的逐 Token Decode,是否与每一步重算完整前缀得到相同结果?
这个问题很好,因为它能被程序反驳。只需要三个文件:
p2-inference-systems/
├── pyproject.toml
├── src/inference_lab/attention.py
└── tests/test_attention.py
从空目录得到它,不需要项目向导:
mkdir -p p2-inference-systems/src/inference_lab p2-inference-systems/tests
cd p2-inference-systems

$EDITOR pyproject.toml
$EDITOR src/inference_lab/attention.py
$EDITOR tests/test_attention.py

uv sync
Shell 只是启动编辑器和构建工具;真正决定项目的内容都已经写进文件。pyproject.toml 先只保存项目名、Python 版本、NumPy 依赖和 Build Backend,不预先注册一堆还不存在的命令。
attention.py 里先写一个慢但容易相信的实现,再写准备验证的 Cache 实现。测试把两者放在同一个输入上:
expected = decode_without_cache(x, wq, wk, wv)
actual, k_cache, v_cache = cached_attention(x, wq, wk, wv)

np.testing.assert_allclose(actual, expected, rtol=1e-7, atol=1e-8)
然后让构建工具重复这个事实:
OPENBLAS_NUM_THREADS=1 \
OMP_NUM_THREADS=1 \
uv run python -m unittest discover -s tests -v
到这里没有 Repository、Service、Factory,甚至没有配置文件夹。但是已经有了一条完整的推理链:
问题
  -> 可计算的参考答案
  -> 待验证的实现
  -> 自动比较
  -> 成功或失败
这就是第一条 Walking Slice。它不是整个项目,却从输入到证据贯通了整个项目最核心的一小块。
为什么一定要先有它?因为后面无论增加 Batch、Multi-Head、GQA 还是真实 vLLM,都必须回答同一个问题:我增加的是能力,还是只是增加了代码? 如果旧的可观察行为还在,项目是在生长;如果旧行为已经无法证明,项目只是在变大。
4. 唯一需要记住的方法:一次消掉一个未知
写系统时最容易陷入两种状态:要么一直“设计”,迟迟没有第一条结果;要么一直加功能,直到没有人知道某个结果为什么正确。
我现在使用的循环只有下面这一条:
提出一个具体问题
  -> 在运行前写下预测
  -> 构造最小可观察例子
  -> 写出一条端到端路径
  -> 让测试或数据指出第一个错误
  -> 修正,并把重复动作交给构建工具
  -> 只重构这次变化暴露出的结构问题
  -> 留下代码、测试或原始数据
重点是“一个”。一次实验既改 Batch Size、Sequence Length,又换模型和线程数,最后得到的图很热闹,但没有回答任何一个问题。一次重构同时引入插件系统、配置中心和异步任务,也很难知道哪一层真正必要。
不过,“一次只消掉一个未知”不是要求永远只写一个函数。它是在决定下一步时问:
当前阻止我继续的第一个不确定性是什么?
在第一个 Cache 实现里,不确定性是数值等价;在 Batch 实验里,不确定性是多个 Sequence 有没有共享状态;进入真实 Serving 后,不确定性才会变成排队、调度、KV Block 与流式延迟。问题变了,项目才有理由长出新的结构。
5. 项目结构不是设计出来的,是被问题“压”出来的
5.1 第一次压力:一个函数已经装不下实验
Cache 正确以后,我要比较 No Cache、Dynamic Cache 和 Preallocated Cache 的耗时。计时需要 Warm-up、重复运行、固定随机种子和保存样本。
如果把这些都塞进 attention.py,机制实现和实验流程会因为不同原因变化:前者因为算法变化,后者因为实验协议变化。于是项目第一次自然分开:
src/inference_lab/
├── attention.py      # 机制:Attention 与 KV Cache 怎样工作
└── benchmark.py      # 实验:怎样构造输入、预热、计时并写出样本
这不是为了满足某种目录规范。拆分的原因非常具体:我希望修改 Warm-up 次数时,不必碰 Attention;修改 Attention 时,正确性测试仍然可以直接调用它,而不是启动整套 CLI。
5.2 第二次压力:最终数字已经无法解释自己
最初只打印平均耗时似乎够用。很快问题出现了:一次早期实验没有固定 BLAS 线程,No Cache 看起来获得了四十倍以上的异常“加速”。如果只保留最后一张表,现场已经无法恢复。
于是 Raw Data 出现了:
results/
└── m1-batch-size-scan/
    ├── raw.csv
    ├── summary.csv
    ├── latency-p50-p95.svg
    ├── throughput-positions-per-second.svg
    └── knee-analysis.md
同时,汇总逻辑从 Benchmark 中分离:
benchmark.py              产生事实
summarize_batch_size_scan.py   读取事实,生成解释材料
现在任何一个 P50、P95 或吞吐曲线点都能重新从 raw.csv 计算。raw.csv 不能证明实验设计一定正确,但它防止了“图还在,现场没了”。
注意顺序:不是第一天先建一个 results/raw/processed/figures/archive 帝国,而是当一个汇总数字不足以回答异常时,项目才长出 Raw Artifact 和独立汇总器。
5.3 第三次压力:单 Head 模型解释不了真实 KV 容量
当前项目正在推进 M2。已有的 attention.py 仍是单 Head;M2-A1 已经把 Head 轴从扁平特征中可靠地拆出,M2-A2 又把这套规则迁移到 Q/K/V,并增加输入契约。M2-B 随后在 H_q=H_kv 条件下完成无 Cache Causal MHA,把每个 Batch、Head 和 Query Token 的 Score、Mask、Softmax 与 Value 聚合连接起来。
这时项目才增加:
src/inference_lab/multi_head_attention.py
tests/test_multi_head_attention.py
第一步仍然不是完整 Attention,只是一个轴变换:
def split_heads(projected: np.ndarray, num_heads: int) -> np.ndarray:
    """Convert [B, T, H * D_head] into [B, H, T, D_head]."""
为什么如此小?因为 [B, T, H × D_head] -> [B, H, T, D_head] 有两个不同的失败方式:Shape 可以正确,Head 和 Sequence 的元素位置却仍然放反。最小的 Shape 测试加一个非零坐标的元素映射测试,恰好能暴露这两个问题。
Head 轴有了 A1 的测试保护后,M2-A2 把同一规则迁移到 Q/K/V,并在 reshape 前检查输入维度、Head 整除关系和一致的 D_head。M2-B 又用独立标量 Oracle 验证了缩放点积、Causal Mask、稳定 Softmax、逐 Head Output、Future Token 不可见以及 Batch/Head 隔离;定向评分为 60/60,整份作业为 100/100,16 项私人回归全部通过。下一步才进入 Cached MHA,之后再处理 GQA 映射和容量公式。模块的名字和边界由已经理解的机制决定,而不是由想象中的最终 Transformer 决定。
5.4 第四次压力:Toy 实验回答不了真实服务问题
NumPy Lab 可以证明 Cache 复用、Batch 维和 Head 映射,却不能证明 vLLM 如何排队、怎样形成 Batch,或 GPU 上的吞吐为何饱和。
所以 M2 结束后,正确动作不是继续补 MLP、Tokenizer 和 Sampling,把 Toy Transformer 越写越大;而是把 vLLM 当作外部系统,通过真实 HTTP 请求、服务端 Metrics、日志和固定版本源码观察它。
到那时,Serving Harness、Metrics Snapshot 和 Source Trace 才会出现。它们不会被塞进 attention.py,因为它们回答的是另一组问题:怎样制造负载、怎样保存服务端现场、怎样把现象追到实现。
这也是为什么现在不需要先造一个 Job Gateway。外层 Queue 和 Worker Pool 看起来更像“完整系统”,却可能挡住真正想观察的 vLLM Scheduler。
6. 为什么最后会显得有条理?
有条理不是因为目录漂亮,而是因为每类事实只有一个自然的去处。
pyproject.toml   怎样得到可运行环境和命令
src/             系统怎样工作
tests/           哪些行为不能被破坏
results/         某次运行实际发生了什么
docs/            为什么这样做,以及下一步做什么
README.md 一个新来的人怎样进入项目这棵树背后只有一个判断标准:把会因为同一种原因变化的内容放在一起,把因为不同原因变化的内容分开。
什么时候应该拆文件?我现在用四个非常朴素的信号:
- 一个文件同时在回答“机制怎样工作”和“实验怎样运行”;
- 为了测试核心逻辑,不得不启动 CLI、网络或整套环境;
- 一个输入变化需要在很多地方重复修改同一知识;
- 某段输出已经成为结论依据,却不能从保存的原始输入重新生成。
没有这些信号,就不急着抽象。出现这些信号,也不需要重写全项目:移动最小的一块,让旧测试继续通过,再从新的入口增加行为。
这就是重构在整个方法里的位置:它不是开工仪式,也不是项目完成后的大扫除;它发生在已有行为被保护,而下一次变化已经暴露出结构摩擦的时候。
7. 构建工具是项目的可执行记忆
只用编辑器写代码并不困难。真正容易丢失的是:昨天到底用哪个版本、哪组参数、什么顺序得到今天的结果?
构建工具的价值不是显得专业,而是把短期记忆搬进项目。
当前 Lab 至少有三种可重复动作:
# 得到环境
uv sync

# 运行正确性回归
OPENBLAS_NUM_THREADS=1 OMP_NUM_THREADS=1 \
  uv run python -m unittest discover -s tests -v

# 重新产生 Batch Size 原始数据和汇总
OPENBLAS_NUM_THREADS=1 OMP_NUM_THREADS=1 \
  uv run p2-inference-systems --experiment batch-size \
  --csv results/m1-batch-size-scan/raw.csv

OPENBLAS_NUM_THREADS=1 OMP_NUM_THREADS=1 \
  uv run p2-inference-systems-summary \
  --input results/m1-batch-size-scan/raw.csv \
  --output-dir results/m1-batch-size-scan \
  --sequence-length 128 --dtype float64 --blas-threads 1
这里最重要的不是 uv。换成 make test、cmake --build 和 ctest,方法完全一样:
- 人只决定“我要验证什么”;
- 工具负责稳定地重复“怎样验证”;
- 命令、依赖和关键环境变量留在项目里,而不是留在 Shell History 里。
每次发现自己第三次手工输入同一组命令,就应该考虑把它变成构建目标或脚本。每次发现“一键运行”会掩盖关键参数,就把参数打印进 Manifest 或日志。自动化不是越多越好;它应该减少思维中断,同时保留因果链。
8. 只有朴素工具,怎样调试一个越来越大的系统?
调试不是盯着整个项目想“哪里错了”,而是寻找第一个与预测不同的可观察状态。
仍然以当前 Lab 为例。
Shape 对了,结果还是错
不要先读完整 MHA 实现。构造顺序值数组,手算一个非零坐标:
q[b, h, t, d]
  == projected[b, t, h * D_head + d]
如果不等,错误就在拆分或交换轴这两步之间。大数组和真实模型暂时都与问题无关。
Batch 结果错了
先分别运行每个 Sequence 的参考实现,再与 Batched 路径逐项比较。只修改其中一个 Sequence,观察另一个输出是否变化。若变化,问题不是“Batch 性能不好”,而是状态隔离已经被破坏。
性能结果离谱
先保留全部样本,再检查线程数、Warm-up、运行顺序和计时边界。早期四十倍以上的异常结果不是靠更多理论消失的,而是靠固定 BLAS 线程并比较前后样本漂移定位的。
客户端延迟变高
客户端只能证明端到端现象,不能自动证明 Scheduler 因果。需要把 Request Event 与服务端 Metrics、日志或固定版本源码对齐;证据不足时,结论就是 Inconclusive。
这些例子看似不同,动作其实相同:
缩小输入
  -> 找到一个可信参考
  -> 比较边界上的状态
  -> 把失败保存成测试
  -> 修正最靠前的错误
编辑器足以写出最小失败样例,构建工具足以反复运行它。Profiler、Debugger 和 Trace 当然有用,但它们是在这个模型上增加观察能力,而不是替代“我要观察什么”的判断。
9. 怎样让这种能力真正属于自己?
独立并不等于不查文档,也不等于拒绝 AI。真正需要独立的是:把模糊问题变成可运行例子、判断第一个错误在哪里,并在条件改变后重新完成一次。
我把训练分成三遍。
第一遍:跟着一条窄路径做出来
只阅读当前步骤所需的最小材料,写下运行前预测,然后实现一条能被测试的路径。M2-A1、M2-A2 与 M2-B 的私人工作表依次保存了 Head 轴、Q/K/V 投影和无 Cache MHA 证据;B 只增加 Score、Mask、Softmax、逐 Head Output 和隔离性测试,没有顺手完成 Cached MHA 或 GQA。
这一遍练的是“把知识变成行为”。
第二遍:关闭答案,从空白处重建
测试通过后,关闭文章、AI 对话和原实现,在临时文件里重新写出核心变换。然后解释每个轴、每个中间 Shape 和一次具体元素映射。
如果只能认出正确答案,却不能重新构造它,掌握仍停在阅读层。
第三遍:只改变一个条件
把 H_q=H_kv 改成 H_q=8, H_kv=2,或把单请求改成并发请求。先预测哪些结论仍成立、哪些会变化,再修改实现与测试。
这一遍练的是迁移。能够修改一个条件而不推倒重来,才说明脑中形成了机制,而不是记住了文件。
一次 120 分钟练习应该留下什么?
Question:
  单步 Q/K/V 是 [B,H,1,D_head] 时,怎样证明 Cached Output
  与完整前缀重算的最后位置数值等价?

Prediction:
  第 t 步 Cache=[2,3,t+1,5]、Weight=[2,3,1,t+1]
  逐 Head Output=[2,3,1,5],Batch/Head 互不污染

Pre-read:
  Hugging Face Caching 的 Cache update 与逐 Token Shape(15 min)

Action:
  先写逐位置 Full-Recompute 对照、Cache 内容与隔离性测试;再追加 K/V

Feedback:
  unittest 的第一个失败 + 每一步 Shape/前缀检查 + M2-B 完整回归

Artifact:
  multi_head_attention.py、test_multi_head_attention.py、checkoffs/m2-c-cached-mha.md

Transfer:
  关闭代码后重做逐步推导;下一轮才进入 GQA Head 映射
AI 最适合站在 Feedback 一侧:检查我的预测、制造反例、Review Diff、指出证据断点。若 AI 直接生成了整套实现,我仍要完成第二遍和第三遍;否则得到的是一次交付,不是可以迁移的能力。
10. 把方法放回我当前的学习主线
这篇文章不是在宣称我已经完成了一个 vLLM Serving 系统。当前仓库能证明的是:
- 已实现 No Cache、Dynamic Cache、Preallocated Cache 与固定形状的 Batched Decode;
- 已用 Oracle 和测试约束正确性;
- 已保存 M1 的 240 条 Batch Size 原始样本,并能重建汇总与曲线;
- 已完成 P0 的 NumPy View/Copy、Stride 与轴语义练习;
- 已完成 M2-A1 的 Query Head 轴变换,3 项定向测试与完整 9 项回归测试通过。
- 已完成 M2-A2 的 Q/K/V 投影与输入契约,A2 定向 6 项、完整 12 项回归与闭卷 Shape 推导通过。
- 已完成 M2-B 的无 Cache Causal MHA;公开定向评分
60/60、整份评分100/100,私人仓库 16 项回归通过,并完成 Score/Output 坐标与 Softmax 轴的闭卷解释。
还不能证明的是 Cached MHA、GQA、真实 vLLM 的排队与调度、流式 TTFT/ITL、Prefix Reuse 和源码因果。这些仍是后续工作,不能因为路线图写得完整就当作系统已经完成。
当前唯一动作转为 M2-C:
冻结 Cached MHA 的输入、Cache 与逐位置 Output 契约
  -> 用已完成的无 Cache MHA 作为 Full-Recompute Oracle
  -> 先证明逐位置等价与 Cache Shape
  -> 再实现追加/更新,不提前进入 GQA
  -> 运行定向测试、完整回归和闭卷推导
M2-C 通过后才依次进入 GQA 和 KV 容量;M2 通过后停止扩展 Toy Transformer。阶段 2 的一个月核心交付只继续完成真实 vLLM 环境、稳态基线、输入长度、并发、调度预算和最终性能报告;Mixed Prefill/Decode、Prefix Reuse、源码追踪与跨环境迁移保留为进阶扩展,不再阻塞原定阶段产出。
整条路线看起来很长,但每天面对的仍然只是一个能失败的小问题。系统的完整性来自这些小闭环能够首尾相接,不是来自某一天突然写完了所有模块。
11. 最后一次验收:作者离开房间
项目什么时候可以称为完整?让另一名开发者只拿到仓库,在没有作者解释的情况下完成一次演示:
- 从干净环境执行文档里的命令,构建并运行;
- 用一个最小输入观察核心行为;
- 故意破坏一条不变量,看到测试在正确位置失败;
- 从原始记录重新生成一个汇总结果;
- 修改一个已声明的条件,并知道应该改哪段代码、补哪个测试。
如果第二步依赖 IDE 里某个忘记记录的按钮,第三步只能靠作者肉眼判断,第四步只剩截图,第五步需要全局搜索后碰运气,那么项目还没有完成交接。
反过来,只要这些动作成立,即使系统只有一台机器、几个模块和朴素的命令行,它也已经是一个完整、可读、可以继续生长的项目。
Take-away Messages
- 不要从目录开始;从一个能被反驳的行为开始。
- 永远保住一条从输入到证据的可运行窄路径。
- 新模块应该由真实变化压力产生,不由架构名词产生。
- 测试保存行为,Raw Data 保存现场,构建工具保存重复方法,文档保存理由。
- 重构发生在旧行为已有保护、下一次变化暴露结构摩擦的时候。
- 独立能力的验收不是“这次写完”,而是能从空白重建,并在改变一个条件后再次完成。