RPC 入门:一次远程调用是怎样完成的
系列入口:分布式阅读路径。 前置:操作系统、网络、并发与存储。 下一篇:Socket 入门。
在业务代码里,我们可能见过这样的调用:给客户端对象一个文件名,拿到文件大小。真正存放文件的机器却在远处。这一行代码究竟做了什么?
本文始终围绕同一个例子:笔记本上的程序,要查询存储服务器上 report.txt 的大小。 假设文件没有复制到本机,远端目录也没有挂载到本机;程序通过文件服务访问它。
怎样读这篇文章
先走通一次调用
只需要会读简单的 C++ 函数。涉及的进程、消息和通信概念,会在用到时解释。
- 前四节建立调用模型:为什么要跨进程、参数怎么过去、结果怎么回来、等待和失败意味着什么。
- 接着用 gRPC C++ 对照这个模型,认识工作代码里常见的名字。
- 最后的进阶部分按需展开,包含异步 API、对象生命周期和重试。
前半篇使用标明的伪代码,不要求搭建环境或实现 RPC 框架。先试着在脑中跟随一次请求,再回头看术语。
本地调用与远程调用
请求与响应
把刚才的过程连起来
一次成功的调用
沿着图中的箭头走:蓝色箭头把请求送到文件服务,绿色箭头把结果送回笔记本。两边各自执行代码;同步调用期间,客户端的调用线程等待这次查询完成。
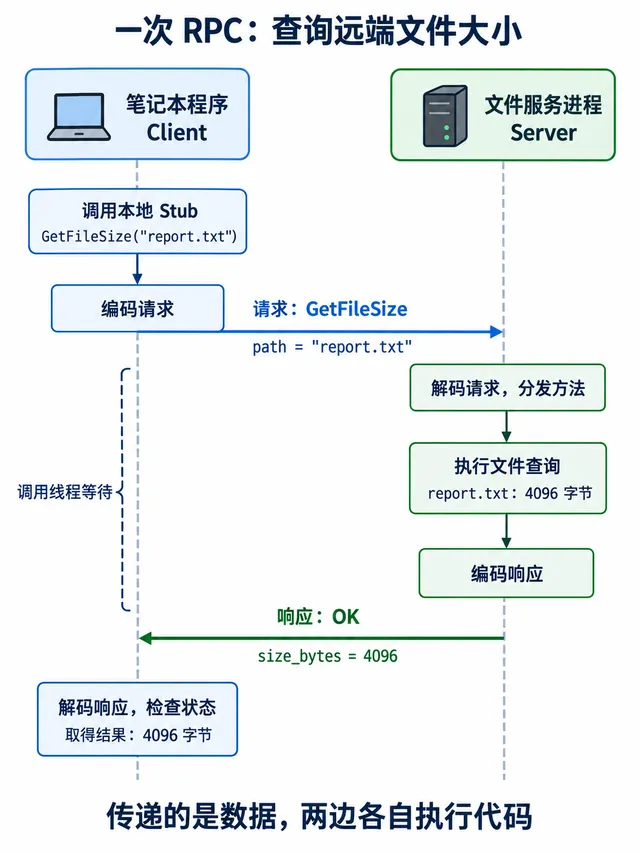
当本地代理返回结果时,远端的业务函数已经在另一个进程中执行过。调用方写的是一行调用,背后经过了请求发送、远端处理和响应返回。
停一下:把边界说清楚
谁的代码,谁的内存?
试着解释:客户端调用 GetFileSize 时,是把这个函数的代码发给服务器吗?服务器得到的请求对象,是客户端原来的那个对象吗?
展开推理
本例的查询代码事先就在服务端。客户端发送的是操作标识和参数,服务端选择已经提供的方法来执行。
客户端与服务端也分别拥有自己的请求、响应对象。网络上传的是编码后的数据;客户端线程和对象的地址都不会随着调用搬到服务器中。
如果能说清楚“本地入口负责发起请求,远端函数负责查询,结果通过响应回来”,这一段的主线就已经走通了。
同步 RPC 与异步 RPC
我们已经知道请求和响应怎样往返。下一个问题是:响应还没回来时,调用方的线程在做什么?同步与异步接口主要在这里分开。
失败语义
接口定义
前面已经建立了 RPC 的调用模型。现在选择 gRPC 这个具体框架,看看它如何把“查询远端文件大小”变成程序里的接口。RPC 是调用方式,gRPC 是一种具体实现。 接下来出现的类名和 API 属于 gRPC C++。
gRPC C++ 接口
下面的代码用于阅读调用路径,依赖前面的 file.proto 生成代码和 gRPC C++ 环境,省略头文件、main 及完整启动与退出流程。它们不是独立的可运行工程。
把代码与消息重新对应起来
两个 GetFileSize,两份 response
客户端和服务端都有 GetFileSize,名字相同是为了表达同一个操作。客户端执行的是 Stub 的方法;服务器收到消息以后,在自己的线程中调用 FileServiceImpl::GetFileSize。
客户端传入 &response,服务端也拿到一个响应指针。这两个指针都用于各自进程内的函数调用,指向各自的对象。框架把服务端填写的 4096 编码发回,再填入客户端的 response。
到这里,可以沿着同一个值读完整条路径:
客户端填入 path = "report.txt"
→ 框架发送请求
→ 服务端 request->path() 得到 "report.txt"
→ 服务端填入 size_bytes = 4096
→ 框架返回响应
→ 客户端确认 status.ok(),再读取 response.size_bytes()
阅读工作中的 RPC 代码
对照现成代码
读一个同步方法就够开始
gRPC 官方的 Route Guide 示例使用地理位置查询。可以先只追 GetFeature 这一条调用,把它与本文的 GetFileSize 对照:
route_guide.proto:方法的输入和输出分别是什么?route_guide_client.cc:请求字段在哪里填写,结果在哪里读取?route_guide_server.cc:对应的处理函数做了什么?
先读懂一个方法的往返,再扩展到同一个项目中的其他调用。教程入口:gRPC C++ Basics。
进阶:异步 API 与重试
下面补充工作代码里可能遇到的细节。可以在需要时展开,主线中的同步与异步概念并不依赖先掌握这些 API。
按问题展开
gRPC C++ 的异步回调怎样取得结果?
下面使用前面的 FileService 和一个由外层持有的 Stub。它对应的是“一次请求、一次响应”的 Unary RPC。代码是阅读片段,省略外围函数及程序退出时的等待逻辑。
struct CallState {
    grpc::ClientContext context;
    demo::GetFileSizeRequest request;
    demo::GetFileSizeResponse response;
};

auto call = std::make_shared<CallState>();
call->request.set_path("report.txt");
call->context.set_deadline(
    std::chrono::system_clock::now() + std::chrono::seconds(2));

stub->async()->GetFileSize(
    &call->context, &call->request, &call->response,
    [call](grpc::Status status) {
        if (status.ok()) {
            std::cout << call->response.size_bytes() << '\n';
        } else {
            std::cerr << status.error_message() << '\n';
        }
    });
// 发起后可以继续安排不依赖本次结果的工作。
CallState 保存本次调用要用的 Context、请求和响应。lambda 按值捕获 shared_ptr,让这些对象一直存活到回调处理结束,避免外层局部变量先销毁,而 RPC 还在使用它们。
这只是对象生命周期安排。程序仍然需要等待正在进行的调用完成,再退出;shared_ptr 不能阻止进程结束。回调之外的代码如果要取得结果,也需要明确的同步方式,不能在响应仍被填写时直接读取它。
取消或超时后也要处理最终完成通知,再按对应 API 的约定释放状态。不要假设回调发生在发起线程,也不要假设多个调用按发起顺序完成。回调应尽量简短,避免长时间阻塞处理线程;同时需要限制尚未完成的调用数量。
示例对应 Callback tutorial:Unary client。当前 gRPC C++ 的 Best Practices推荐使用 Callback API;已有项目也可能使用下面的 CQ API。
Completion Queue 是什么?为什么异步代码里还有等待?
Completion Queue,简称 CQ,是另一套取得异步完成通知的方式。可以把它理解为一个完成事件队列:先登记要做的事,再从队列取出通知,识别哪个操作已经完成。
| 在 Unary 客户端中看到的代码 | 对应的动作 |
|---|---|
AsyncGetFileSize(...) | 发起调用,并把它关联到 CQ |
Finish(&response, &status, tag) | 安排接收最终响应和状态,登记一个完成标识 |
cq.Next(&tag, &ok) | 等待并取出一个完成事件 |
tag 用来识别完成的是哪个操作。对应 Finish 的事件被取出后,才读取这次调用的最终响应和状态。
这里容易混淆三个判断:
Next(...)返回true:取到了事件。返回false则表示 CQ 已关闭并且事件已取完,不代表某次 RPC 失败。- 输出参数
ok:含义取决于事件类型。客户端Finish的完成事件按 API 约定应为true,即使这次 RPC 最终失败。 status.ok():本次 RPC 的最终状态是否为OK。取得完成事件后,还要检查它。
Next 本身会阻塞等待事件。如果在同一线程里发起一个调用后立刻等它,这段流程仍然要等待。也可以先发起多个独立调用,再取完成事件,或者用专门线程处理 CQ,让其他工作继续进行。
所以异步表示“发起”和“完成处理”分开;程序最终仍然需要在合适的位置接收结果。流程见 gRPC C++ Async tutorial,事件语义见 CompletionQueue::Next。
客户端异步,服务端也必须异步吗?
在服务定义和 gRPC 协议兼容的前提下,两边可以独立选择 API。
| 客户端 API | 服务端 API | 客户端怎样取得结果 |
|---|---|---|
| 同步 | 同步或异步 | 在调用点等待,结束后检查状态 |
| 异步 | 同步或异步 | 通过回调或完成事件检查状态 |
服务端的同步处理函数填写响应并返回状态;CQ 服务端通过事件推进处理,调用 responder 的 Finish(...);Callback 服务端通过 Reactor 接口提交完成结果。自定义 Reactor 在 OnDone() 中处理最终清理,默认 Reactor 则由框架管理。具体写法见 Callback tutorial:Unary server。
服务端即使采用异步 RPC 接口,业务函数也可能同步等待磁盘或数据库。分析等待时,要沿着实际调用路径看。
另外,Unary / streaming 描述一次 RPC 交换多少请求和响应消息;同步 / 异步描述应用怎样发起并取得结果。这是两个不同的维度:Unary RPC 同样可以使用异步 API。
RPC、gRPC、Protocol Buffers、HTTP 分别处在哪一层?
| 名称 | 在本文中的作用 |
|---|---|
| RPC | 把对远端操作的请求组织成一次调用 |
| gRPC | 提供具体的 RPC 框架和调用协议 |
| Protocol Buffers | 描述消息结构,支持代码生成、编码与解析 |
| HTTP/2 | 标准 gRPC 用来交换请求与响应的协议 |
标准 gRPC 使用 HTTP/2,常用 Protocol Buffers 作为消息格式。因此,“使用 HTTP”和“采用 RPC 调用方式”可以同时成立。RPC 这个概念本身并不限定只能使用某一种编码或传输协议。见 gRPC FAQ。
超时后为什么不能一律重试?
查询文件大小不修改文件,重复读取通常不会产生额外的修改,但文件可能在两次查询之间变化,因此两次结果未必相同。
现在让文件服务再提供一个操作:向文件末尾追加一行。假设它的请求含义是:
AppendText(path="report.txt", text="hello\n")服务端可能已经追加成功,响应却没及时到达,客户端于是超时。此时再发一次相同请求,文件里可能出现两行 hello。这个例子把前面的不确定性变成了实际后果:一次超时之后,重试可能重复执行已经成功的修改。 gRPC 的 DEADLINE_EXCEEDED 定义也明确保留了这种可能。
幂等性(Idempotency)关注的是:同一个操作重复执行,对业务状态的预期效果是否与执行一次相同。追加一行通常不满足这个条件;幂等也不要求每次响应、日志都完全相同。
业务可以约定操作标识 operation_id:同一次追加的重试沿用同一个 ID 和相同参数,新的追加操作使用新 ID。服务端识别已经完成的操作,返回对应结果。要在并发、崩溃和重启后仍然正确,去重记录还需要与业务修改协调持久化和提交;只加一个 ID 字段并不足够。更完整的案例见《分布式基础:RPC 和远程调用》。
还要先判断错误是否值得重试。例如文件不存在,重复查询通常不能解决问题。允许重试时,也要限制次数、整体时间预算,并通过退避与随机间隔避免请求集中重发。具体机制见 gRPC Retry。
取消同样不会自动撤销已经追加的内容。服务端响应取消的边界可对照 gRPC Cancellation。